
圖片去背
去出主體,保住髮絲與細邊,得到透明 PNG。
第一次使用會下載 AI 模型(65 MB),之後快取。
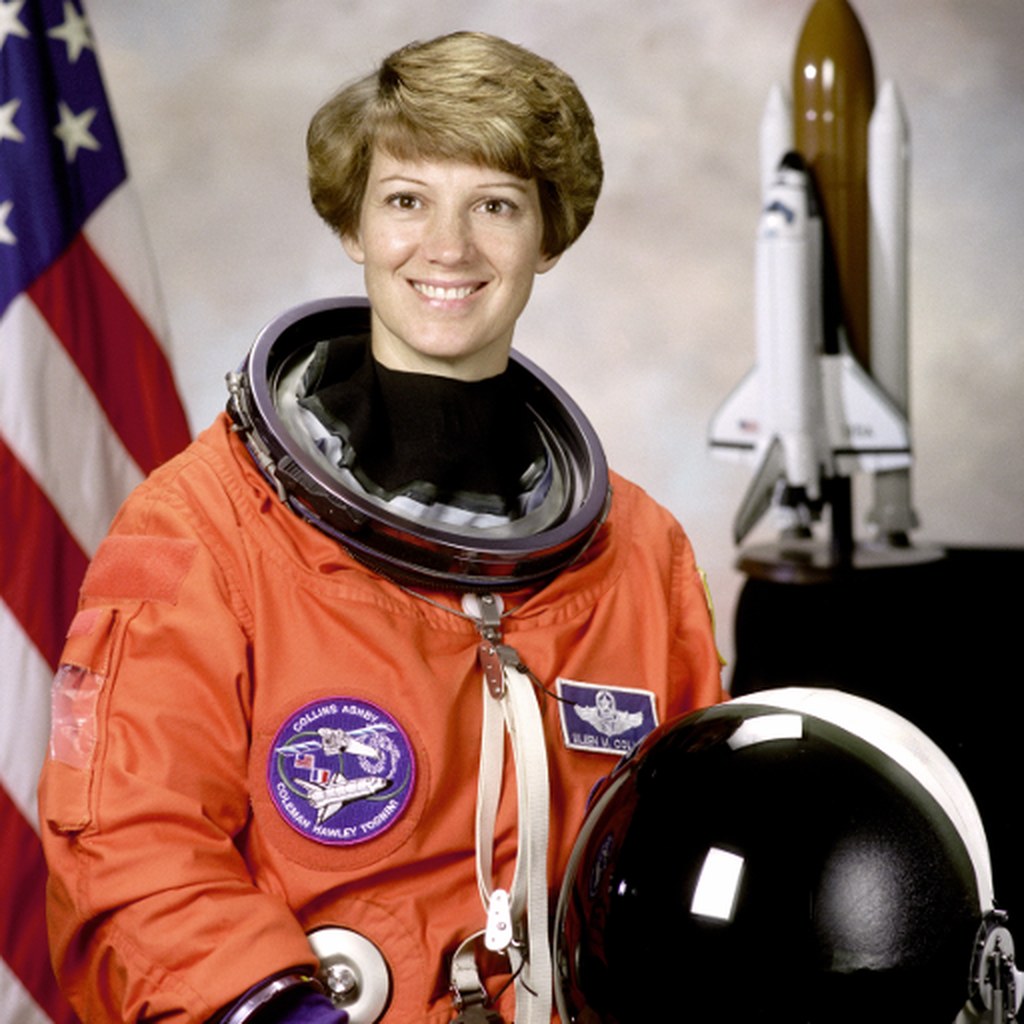
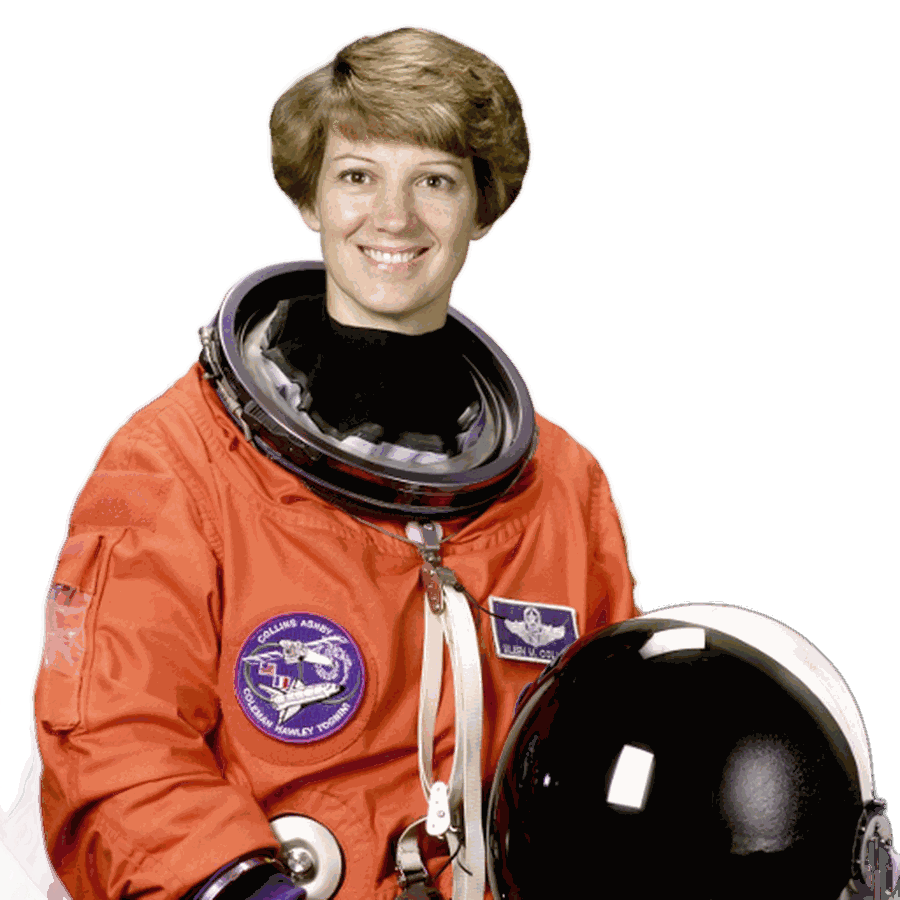
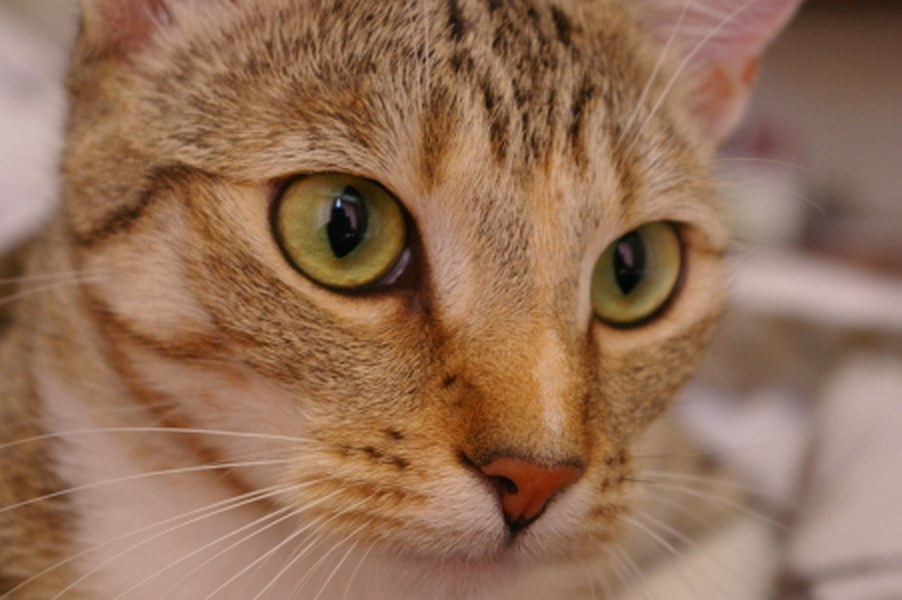
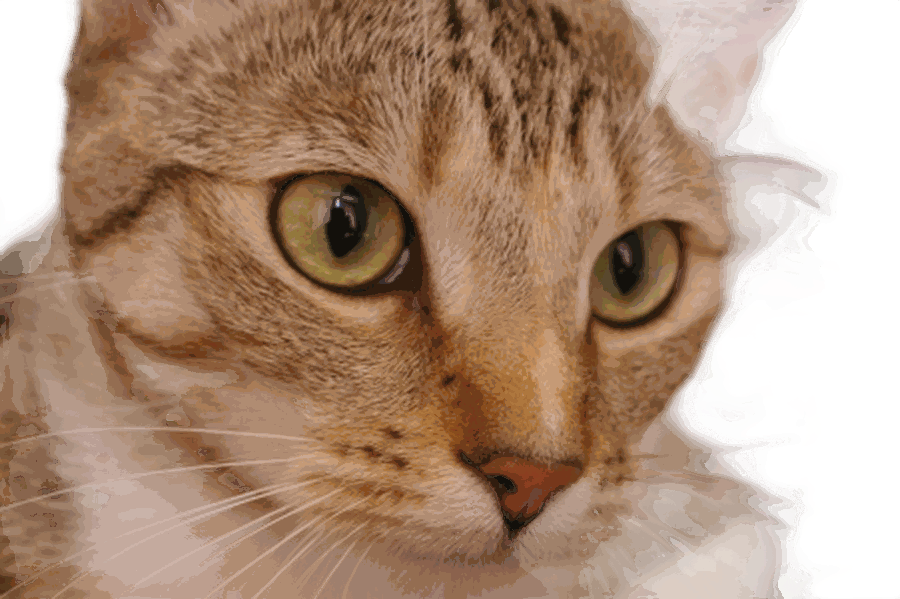
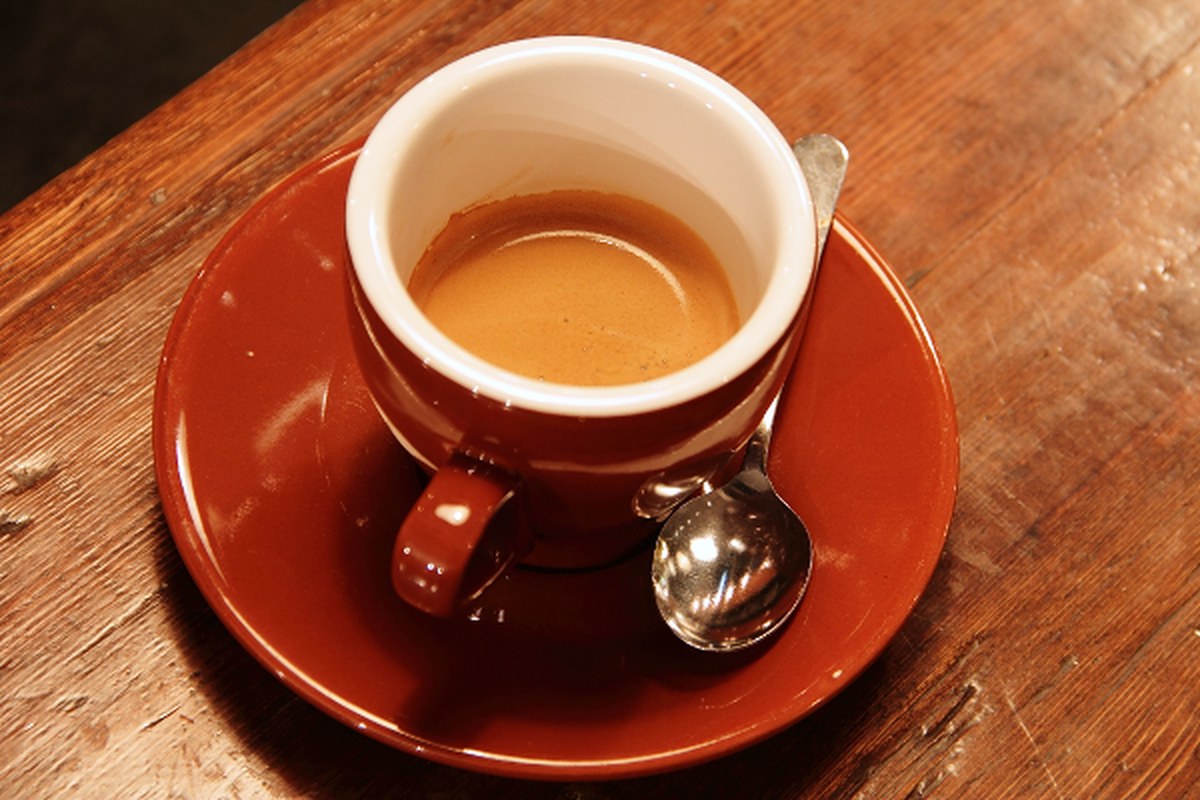
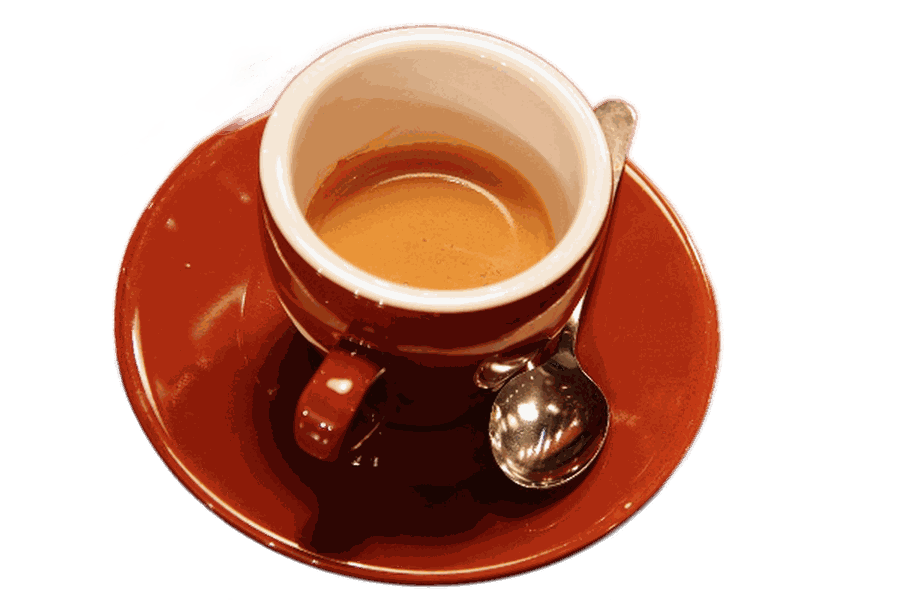
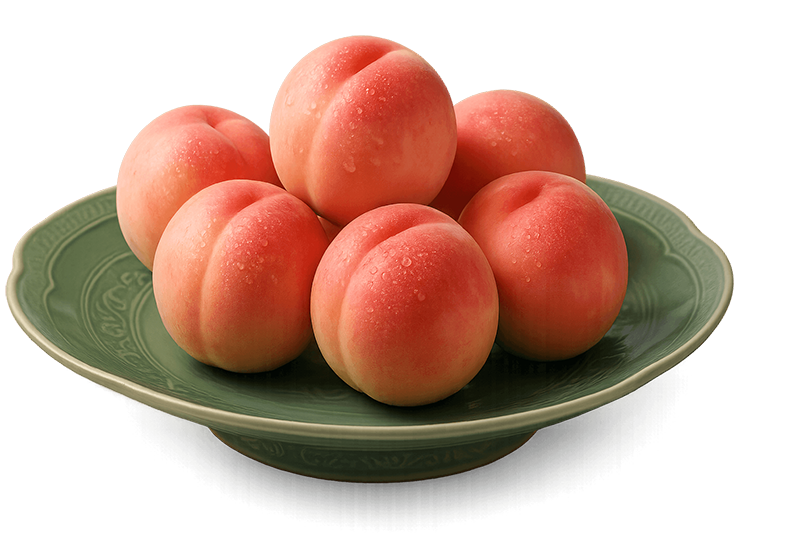
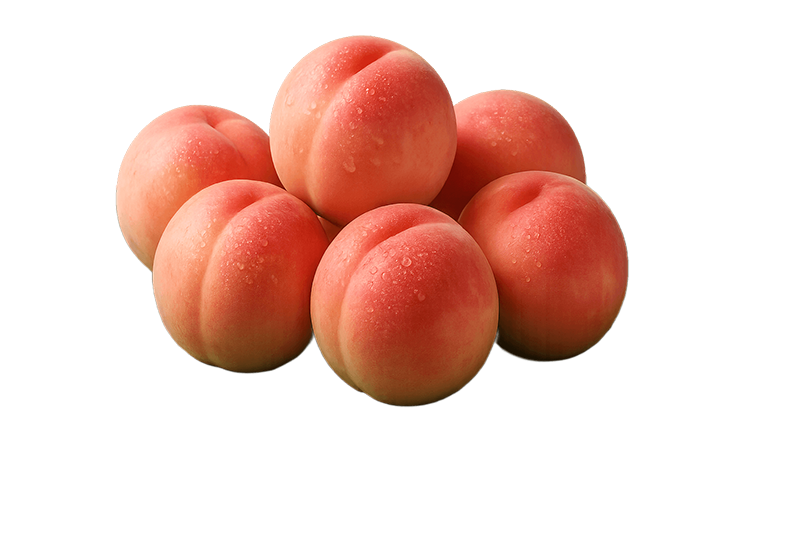
三張照片的實際效果
隨便拉動哪一張的分隔線——左邊是原圖,右邊是去背結果。
- 全部免費不用註冊、沒有次數限制、沒有付費檔。
- 什麼都不上傳檔案在你自己的裝置上處理,不會送到伺服器。
- 結果不打折沒有浮水印,不降質,不限檔案大小。
- 改動都寫下來每一次修復、每一個新工具,都記在更新日誌頁面上。
這個去背工具能做什麼
拖入一張照片,主體在一秒內從背景裡分離出來——人物、商品、動物、汽車、植物、Logo 都行。結果保持照片原解析度,輸出帶真實 alpha 通道的 PNG:髮絲、毛髮、紗網這類半透明邊緣以柔和的透明度保留,而不是生硬地一刀切,這正是去背結果能放到任何新背景上的關鍵。拖動預覽中間的分割線,可以逐像素對比前後效果。
背景可以保持透明、換成白色(電商主圖、證件照)或填任意顏色,邊緣羽化滑桿可以把輪廓柔化最多 5 像素。多張照片可以一起拖入,逐張處理;單張下載或打包 ZIP。去背由 ISNet 完成——一個在高解析度影像上訓練的開源二分類分割網路——透過 WebGPU 在你的瀏覽器裡執行;不上傳,無浮水印,不用註冊,沒有次數限制。
怎麼用
裝置上第一次使用,頁面會拉取 AI 模型(44 MB)和執行環境(21 MB),有進度條,之後快取,再來直接開始。拖入、貼上或選擇照片。每張自動處理;第一張完成的圖出現在對比視圖裡。選背景——透明、白色或取色——和邊緣羽化;這兩項即時生效,不需要重新跑 AI。點「下載 PNG」儲存目前圖,或「全部下載」打包整批。
給模型一個清晰的主體效果最好:一個人、一件商品、一隻動物。主體佔畫面比例大的照片摳得最乾淨;遼闊風景裡的一個小人分到的像素太少。結果可以繼續交給圖片壓縮、圖片尺寸調整或圖片加浮水印;要把去背圖放到新照片上,用任何支援透明 PNG 的圖片編輯器。
常見地雷
速度取決於你的瀏覽器。有 WebGPU——目前電腦上的 Chrome、Edge、Firefox、Safari 26,以及近年的 Android 手機——首次載入後一張照片不到一秒。沒有的話,同一個模型在 CPU 上以 WebAssembly 執行,每張大約 15–25 秒;頁面會告訴你目前是哪種模式,處理期間介面不會卡死。老手機和很舊的筆電可能連模型都裝不下。
主體由模型判斷,它猜不到你的心思。合照會保留所有人,手持商品會保留手,地面上的倒影和陰影通常被去掉(想要陰影就在編輯器裡補)。玻璃、水、薄紗這類透明物體得到的是合理但不精確的透明度。背景雜亂且顏色與主體接近是最難的情況。模型內部按 1024 像素處理,再把遮罩放大回原尺寸,所以 6000 像素大圖的邊緣比 1500 像素的略軟。
背景知識:去背是怎麼做到的
ISNet 是做二分類影像分割的神經網路——判斷每個像素有多大比例屬於前景。它在數千張帶像素級精確遮罩的高解析度影像上訓練,包括頭髮、網眼和細長結構,所以能給出柔和、細緻的邊緣,而不是老模型那種糊成一團的輪廓。網路以 1024 × 1024 執行,輸出機率圖;這張圖放大到原尺寸後就成為照片的 alpha 通道。
本站用的是原始的 Apache 授權權重,卷積權重以 8 位元整數儲存(體積四分之一,遮罩與全精度版本無法區分),切成三個檔案以便普通靜態託管,在瀏覽器裡重新拼接。推理由 ONNX Runtime Web 執行:瀏覽器提供 WebGPU 就走 GPU,否則用 WebAssembly 在 CPU 上跑。照片讀入 canvas、正規化、送進網路、合成回來——每一步都在你的分頁裡,不傳送任何東西,模型快取後頁面離線也能用。
哪些場景需要去背
平台要求純白背景的商品主圖。用純色背景的大頭照和證件照。必須透明才能放到文件上的 Logo 和簽名。用在簡報、海報、封面圖和社群圖片裡的去背圖。在雜亂桌面上拍的二手物品照片。把幾張照片的主體拼在一起的合成和拼貼。用照片做的貼圖和表情。
本站的流程是:在這裡去背,再按平台縮放或壓縮,公開發布就加浮水印,或者把透明 PNG 當作 Logo/印章放到 PDF 上——用PDF 簽名。
常見問題
我的照片會上傳嗎?
不會。AI 模型下載到瀏覽器一次後就在本機執行;照片在你的裝置上處理,不傳送到任何伺服器。首次載入後頁面離線也能用。
為什麼第一次要下載 65 MB?
那是分割模型(44 MB)和它的執行環境(21 MB)。瀏覽器會快取,之後再來以及處理其他照片都是即時開始。
結果是原解析度嗎?
是。遮罩按 1024 像素計算後放大到照片原尺寸,輸出 PNG 與輸入尺寸相同,帶柔和的 alpha 通道。
為什麼在我的裝置上很慢?
沒有 WebGPU 時模型在 CPU 上以 WebAssembly 執行,每張 15–25 秒。目前版本的 Chrome、Edge、Firefox、Safari 在現代硬體上會用 GPU,一秒內完成。
能自己選保留什麼嗎?
不能手動選——模型自動判斷主體。如果保留得太多,先用裁切工具把照片裁到主體。