
背景除去
被写体を切り抜き、髪や細い縁を保ったまま透過 PNG に。
初回のみ AI モデル(65 MB)をダウンロードし、以降はキャッシュされます。
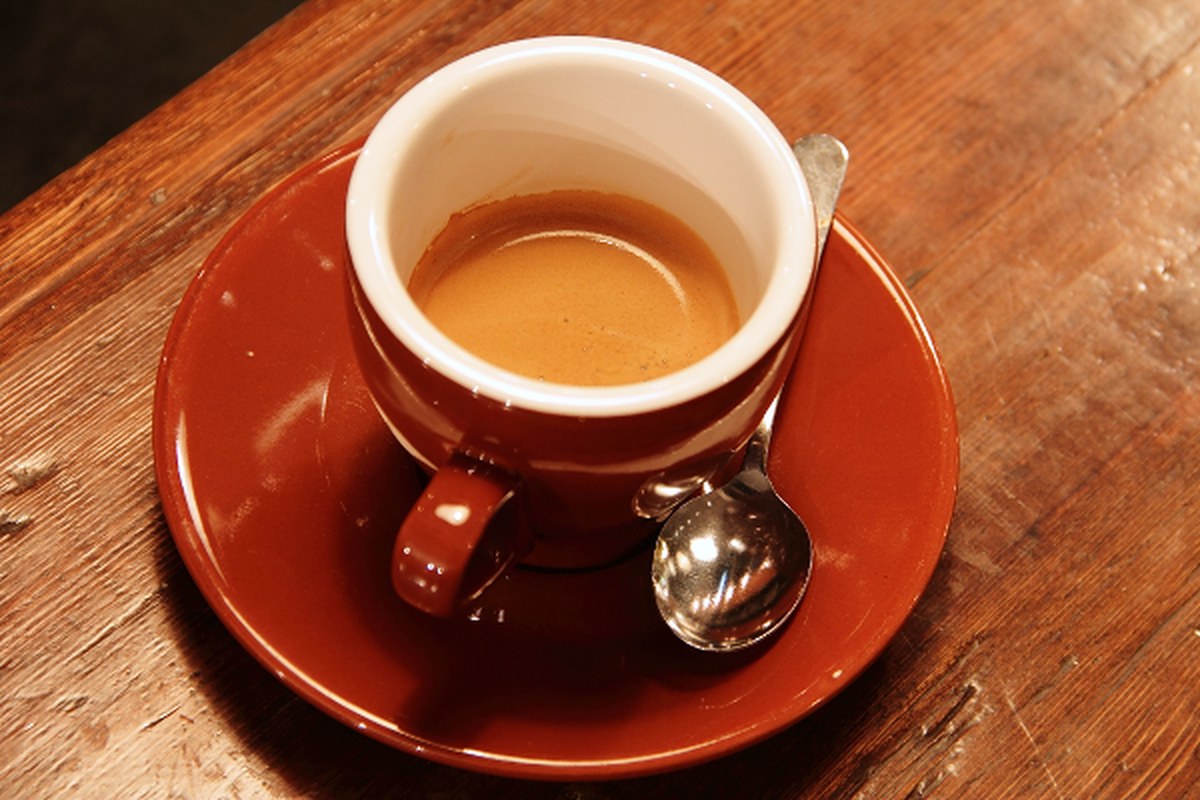
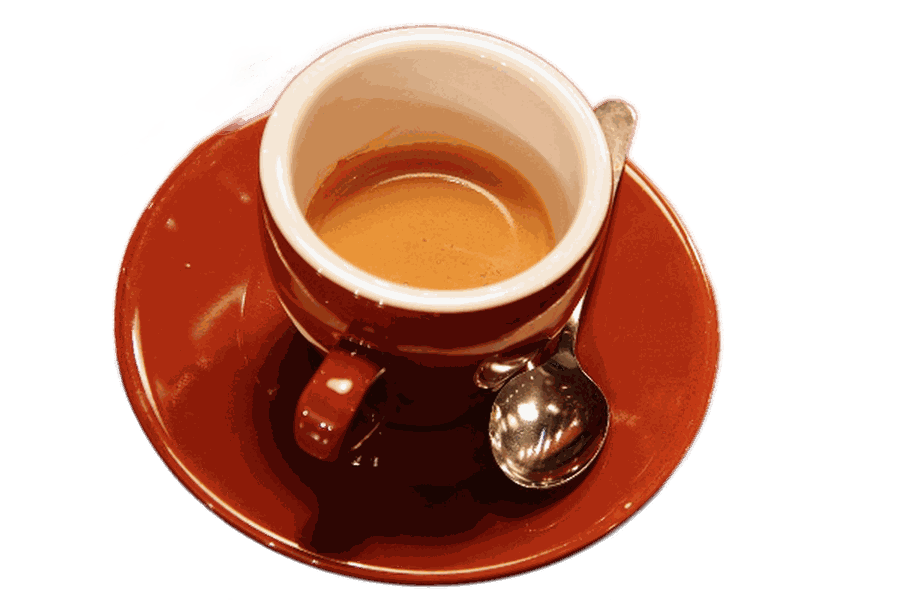
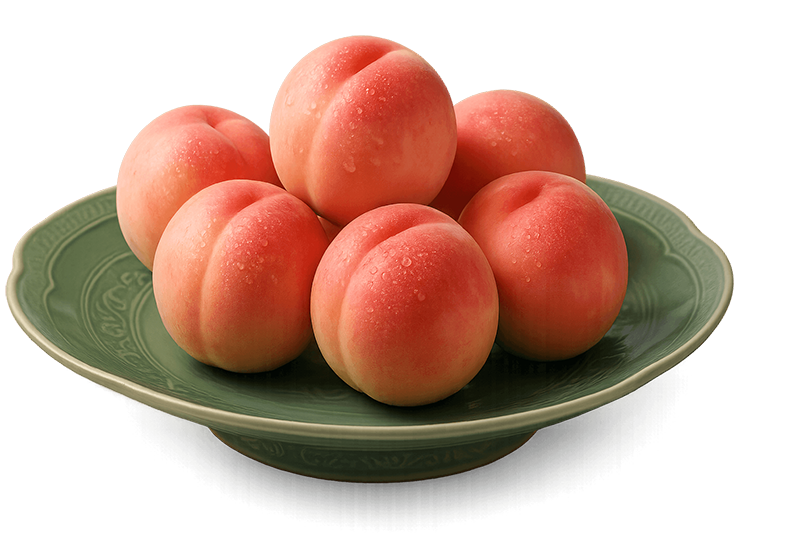
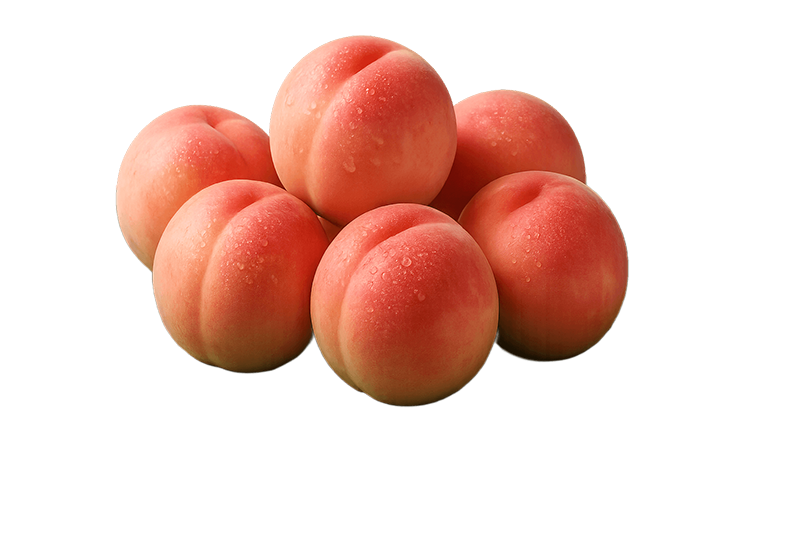
3 枚の写真での実際の仕上がり
どれでも分割線をドラッグしてください——左が元画像、右が切り抜き結果です。
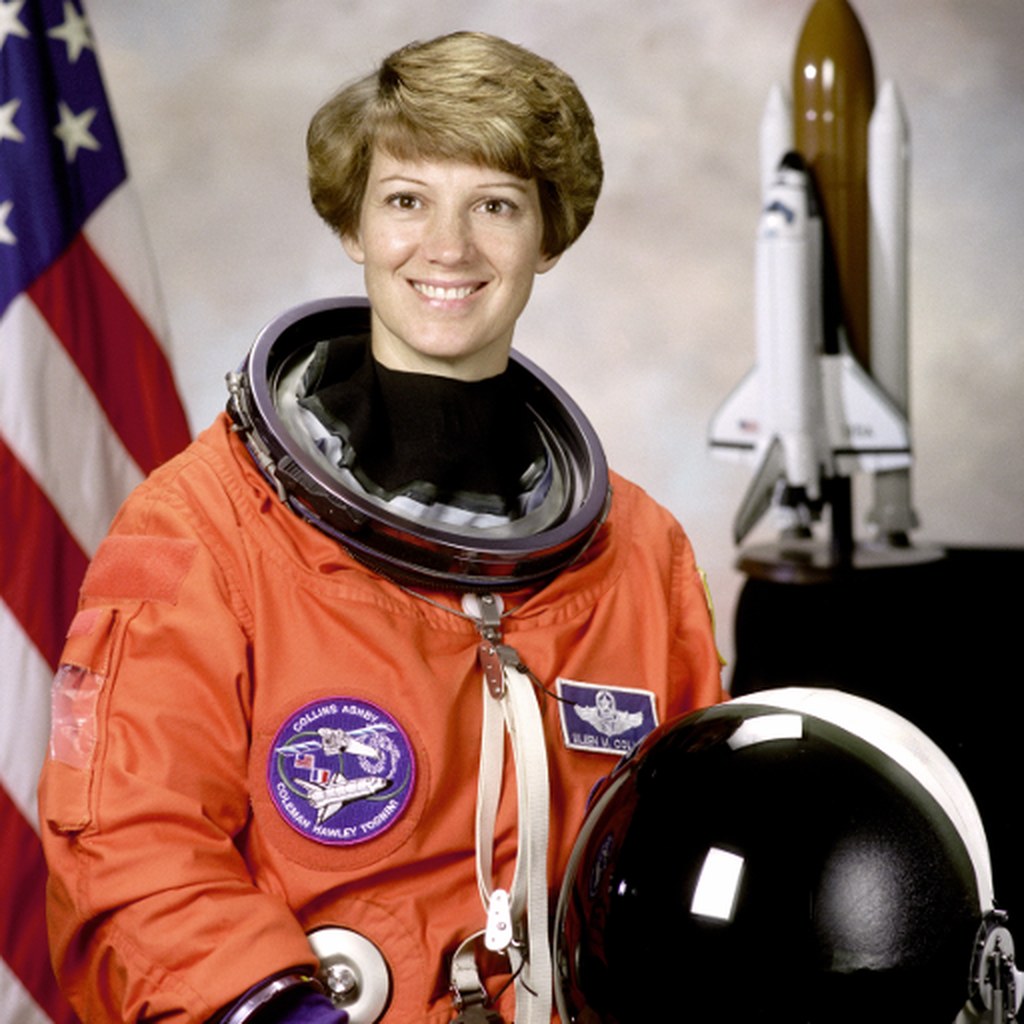
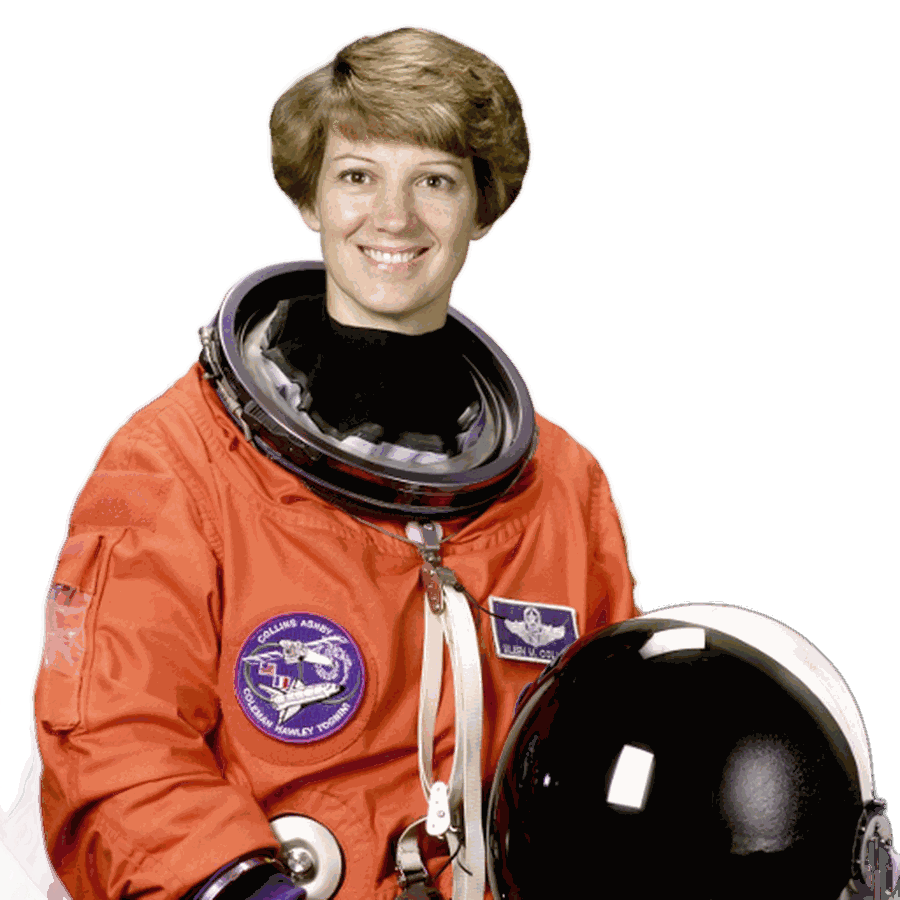
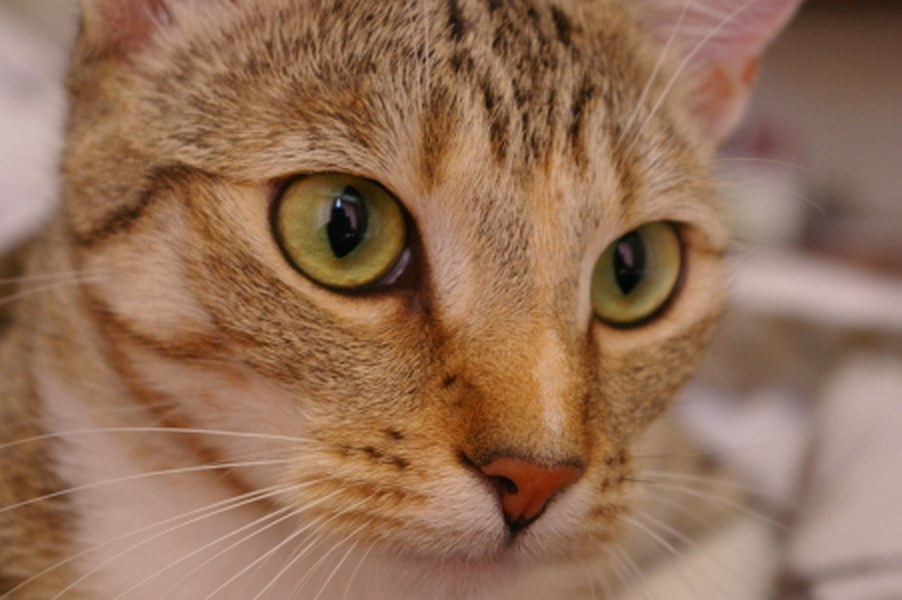
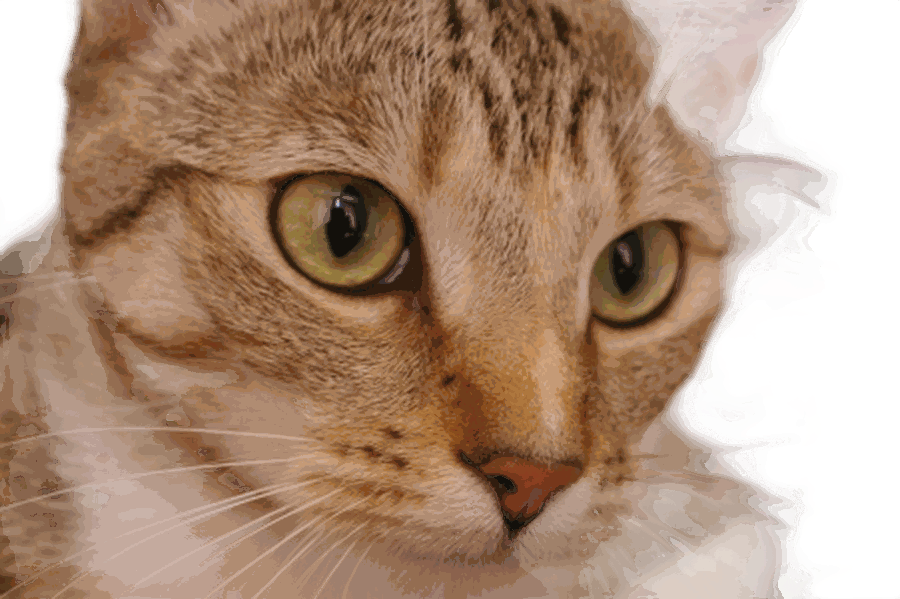
- すべて無料登録なし、回数制限なし、有料プランなし。
- アップロードなしファイルは自分の端末で処理され、サーバーには届きません。
- 結果に条件なし透かしなし、勝手な縮小なし、サイズ上限なし。
- 変更はすべて公開修正も新しい工具も、すべて更新履歴ページに書いています。
この背景除去ツールでできること
写真をドロップすると、最近のパソコンなら 1 秒以内に被写体が背景から分離されます。人物、商品、動物、車、植物、ロゴに対応します。結果は写真の元の解像度を維持し、本物のアルファチャンネルを持つ PNG として出力されます。髪の毛の 1 本 1 本、毛並み、ベールなどの半透明の輪郭は、硬く切り取られるのではなく柔らかな透明度として保持されるため、どんな新しい背景にも自然に載せられます。プレビューの境界線をドラッグすると、処理前と処理後を比較できます。
背景は透明のままにするか、白に置き換えるか(商品掲載や証明写真向け)、好きな色で塗りつぶせます。輪郭のぼかしスライダーで最大 5 ピクセルまで縁を柔らかくできます。複数の写真を一度にドロップすると順番に処理され、個別または ZIP でまとめてダウンロードできます。切り抜きは高解像度画像で学習されたオープンソースの二値セグメンテーションネットワーク ISNet が行い、WebGPU を使ってブラウザ内で動作します。アップロードはなく、透かしも登録も制限もありません。
使い方
端末で初めて使うときは、ページが AI モデル(44 MB)とランタイム(21 MB)を取得します。進捗バーでダウンロードの状況が表示され、キャッシュされるので次回以降はすぐに始まります。写真をドロップ、貼り付け、または選択します。それぞれ自動的に処理され、最初に完了した画像が比較ビューに表示されます。背景(透明、白、または色)と輪郭のぼかしを選びます。これらは AI を再実行することなく即座に結果に反映されます。「PNG をダウンロード」で現在の画像を、「すべてダウンロード」でバッチ全体を保存します。
最良の結果を得るには、モデルにはっきりした被写体を与えてください。1 人の人物、1 つの商品、1 匹の動物などです。被写体が画面の大部分を占める写真が最もきれいに切り抜けます。広い風景の中の小さな人物には割り当てられるピクセルが少なくなります。結果は画像圧縮、画像リサイズ、透かしを追加へ続けて渡せます。切り抜きを別の写真に載せるには、透過 PNG に対応した画像編集ソフトをお使いください。
よくある落とし穴
速度はブラウザに依存します。WebGPU がある環境(現行のパソコンの Chrome、Edge、Firefox、Safari 26、および最近の Android 端末)では、初回の読み込み後は 1 枚あたり 1 秒もかかりません。WebGPU がない場合、同じモデルが WebAssembly で CPU 上で動作し、1 枚あたりおよそ 15〜25 秒かかります。ページにはどちらのモードが有効かが表示され、処理中も操作に応答します。古いスマホや非常に古いノート PC では、モデルを載せるメモリが足りないことがあります。
何が被写体かはモデルが判断し、あなたの意図を読み取ることはできません。集合写真では全員が残り、商品を持つ手は手ごと残り、地面の反射や影はたいてい除去されます(影が欲しければ編集ソフトで足してください)。ガラス、水、薄い布などの透明な物体は、もっともらしいものの物理的に正確ではないアルファになります。被写体と似た色の非常にごちゃごちゃした背景が最も難しいケースです。モデルは内部で写真を 1024 ピクセル版で処理し、その後マスクをフル解像度に拡大するため、6000 ピクセルの画像の輪郭は 1500 ピクセルの画像よりわずかに柔らかくなります。
背景知識:切り抜きの仕組み
ISNet は二値画像セグメンテーション、つまりすべてのピクセルについて前景の物体にどれだけ属しているかを判定するニューラルネットワークです。髪、メッシュ、細い構造を含む、ピクセル精度のマスク付きの数千枚の高解像度画像で学習されているため、従来のモデルのぼんやりした輪郭ではなく、柔らかく細かな縁を生成できます。ネットワークは 1024 × 1024 で動作して確率マップを出力し、そのマップが元のサイズに拡大されて写真のアルファチャンネルになります。
ここで使用しているのは Apache ライセンスのオリジナルの重みで、畳み込みの重みを 8 ビット整数として格納しています(サイズは 4 分の 1 で、マスクはフル精度版と見分けがつきません)。通常の静的ホスティングから配信できるよう 3 つのファイルに分割し、ブラウザ内で再結合します。推論は ONNX Runtime Web で実行され、ブラウザが WebGPU を提供していれば GPU で、そうでなければ WebAssembly で CPU 上で動きます。写真はキャンバスに読み込まれ、正規化され、ネットワークに渡され、合成されて戻ります。すべての工程がタブの中で行われ、どこにも送信されず、モデルがキャッシュされればページはオフラインでも動作します。
背景除去が必要になる場面
白背景が必須のフリマサイトやショップ向けの商品写真。無地の背景にしたいプロフィール写真や証明写真。文書に載せるために透明にする必要があるロゴや署名。プレゼン、ポスター、サムネイル、SNS 画像向けの切り抜き。散らかったテーブルで撮った中古品の出品写真。複数の写真の被写体を組み合わせる合成やコラージュ。写真から作るステッカーや絵文字。
当サイトでの流れは、ここで背景を除去し、プラットフォームに合わせてリサイズまたは圧縮し、公開するなら透かしを追加し、あるいは透過 PNG をロゴや印鑑として PDF 署名で PDF に配置するというものです。
よくある質問
写真はアップロードされますか?
いいえ。AI モデルは一度ブラウザにダウンロードされ、そこで動作します。写真は端末内で処理され、サーバーに送信されることはありません。初回の読み込み後はページはオフラインでも動作します。
初回に 65 MB をダウンロードするのはなぜですか?
セグメンテーションモデル(44 MB)とそのランタイム(21 MB)です。どちらもブラウザにキャッシュされるので、次回以降のアクセスや他の写真の処理はすぐに始まります。
結果はフル解像度ですか?
はい。マスクは 1024 ピクセルで計算された後、写真の元のサイズに拡大されるため、出力される PNG は入力と同じ寸法で、柔らかなアルファチャンネルを持ちます。
自分の端末では遅いのはなぜですか?
WebGPU がない場合、モデルは WebAssembly で CPU 上で動作し、1 枚あたり 15〜25 秒かかります。最新のハードウェア上の現行版 Chrome、Edge、Firefox、Safari では GPU を使い、1 秒以内に完了します。
残す部分を自分で選べますか?
手動では選べません。モデルが主要な被写体を自動的に判断します。余計な部分が残る場合は、先に切り抜きツールで写真を被写体に合わせて切り抜いてください。